Сообщения

Что такое Prometheus

Изображение
Prometheus - это набор инструментов для мониторинга и оповещения систем, изначально созданный в SoundCloud. С момента своего создания в 2012 году, многие компании и организации приняли Prometheus, и проект имеет очень активное сообщество разработчиков и пользователей. Сейчас это самостоятельный проект с открытым исходным кодом, который поддерживается независимо от любой компании. Чтобы подчеркнуть это и уточнить структуру управления проектом, Prometheus присоединился к Cloud Native Computing Foundation в 2016 году в качестве второго размещенного проекта после Kubernetes. Харакетристики Основные функции Prometheus: многомерная модель данных с данными временных рядов, идентифицированными по имени метрики и парам ключ/значение PromQL, гибкий язык запросов, позволяющий использовать эту размерность не зависит от распределенного хранилища; узлы одного сервера являются автономными сбор временных рядов происходит через модель вытягивания (pull model) через HTTP продвижение временных р...
Нормальные формы, пример нормализации в базе данных

Изображение
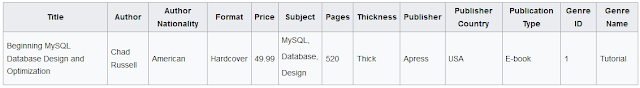
Кодд представил концепцию нормализации и то, что сейчас известно как первая нормальная форма (1NF) в 1970 году. Кодд продолжал определять вторую нормальную форму (2NF) и третью нормальную форму (3NF) в 1971 году, также Кодд и Рэймонд Ф. Бойс определили нормальную форму Бойса-Кодда (BCNF) в 1974 году. Неформально отношение реляционной базы данных часто описывается как "нормализованное", если оно соответствует третьей нормальной форме. Большинство отношений 3NF не содержат аномалий вставки, обновления и удаления. Нормальные формы (от наименее нормализованных до наиболее нормализованных): UNF: ненормализованная форма 1NF: первая нормальная форма 2NF: вторая нормальная форма 3NF: третья нормальная форма EKNF: Элементарный ключ, нормальная форма BCNF: нормальная форма Бойса-Кодда 4NF: четвертая нормальная форма ETNF: нормальная форма основного кортежа 5NF: пятая нормальная форма DKNF: нормальная форма ключа домена 6NF: шестая нормальная форма UNF (1970) 1NF (1...

Нормализация базы данных

Изображение
Нормализация базы данных - это процесс структурирования реляционной базы данных в соответствии с серией так называемых нормальных форм, чтобы уменьшить избыточность данных и улучшить целостность данных. Впервые он был предложен Эдгаром Ф. Коддом как часть его реляционной модели. Нормализация предполагает организацию столбцов (атрибутов) и таблиц (отношений) базы данных, чтобы гарантировать, что их зависимости должным образом обеспечиваются ограничениями целостности базы данных. Это достигается путем применения некоторых формальных правил в процессе синтеза (создание нового дизайна базы данных) или декомпозиции (улучшение существующего дизайна базы данных). Основная цель первой нормальной формы, определенной Коддом в 1970 году, состояла в том, чтобы позволить запрашивать данные и манипулировать ими с помощью "универсального языка данных", основанного на логике первого порядка. (SQL является примером такого подъязыка данных, хотя Кодд считал его языком с серьезными недостатк...

Паттерн наблюдатель (Observer)

Изображение
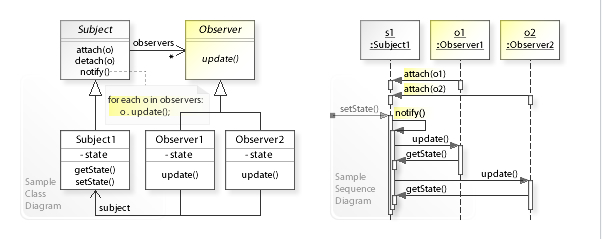
Паттерн наблюдатель (Observer) - это паттерн проектирования программного обеспечения, в котором объект, называемый субъектом, ведет список своих зависимых, называемых наблюдателями, и автоматически уведомляет их о любых изменениях состояния, обычно вызывая один из их методов. Он в основном используется для реализации распределенных систем обработки событий в программном обеспечении, "управляемом событиями" (event driven). В этих системах субъект обычно называется "потоком событий" или "источником событий", в то время как наблюдатели называются "приемниками событий". Номенклатура потока имитирует или адаптируется к физической установке, где наблюдатели физически разделены и не контролируют испускаемые события субъекта/источника потока. Этот паттерн идеально подходит для любого процесса, где данные поступают через ввод/вывод, то есть когда данные недоступны ЦПУ при запуске, но могут поступать "случайно" (HTTP-запросы, данные GPIO, ввод ...

Типы двоичных деревьев поиска

Изображение
Существует много типов двоичных деревьев поиска. Деревья AVL и красно-черные деревья являются формами самобалансирующихся двоичных деревьев поиска. Splay дерево - это двоичное дерево поиска, которое автоматически перемещает часто используемые элементы ближе к корню. В treap (куче дерева) каждый узел также имеет (случайно выбранный) приоритет, а родительский узел имеет более высокий приоритет, чем его дочерние элементы. Деревья танго - это деревья, оптимизированные для быстрого поиска. T-деревья - это двоичные деревья поиска, оптимизированные для сокращения объема памяти, широко используемые для баз данных в памяти. Вырожденное дерево - это дерево, в котором для каждого родительского узла существует только один связанный дочерний узел. Он неуравновешен и, в худшем случае, производительность снижается по сравнению со связным списком. Если ваша функция добавления узла не обрабатывает перебалансировку, то вы можете легко построить вырожденное дерево, передав его уже отсортированным данным...

Примеры применения двоичного дерева поиска

Изображение
Сортировка Бинарное дерево поиска может быть использовано для реализации простого алгоритма сортировки. Как и в случае с heapsort, мы вставляем все значения, которые мы хотим отсортировать, в новую упорядоченную структуру данных - в данном случае это двоичное дерево поиска - и затем перемещаемся по порядку. Наихудшее время для build_binary_tree - O(n*n) - если вы передаете ему отсортированный список значений, он объединяет их в связанный список без левых поддеревьев. Например, build_binary_tree ([1, 2, 3, 4, 5]) выдает дерево (1 (2 (3 (4 (5)))))). Есть несколько схем для преодоления этого недостатка с помощью простых бинарных деревьев; наиболее распространенным является самобалансирующееся двоичное дерево поиска. Если эта же процедура выполняется с использованием такого дерева, общее время наихудшего случая составляет O(n log n), что является асимптотически оптимальным для сортировки сравнения. На практике добавленные издержки во времени и пространстве для сортировки на основе дерев...

Верификация двоичного дерева поиска

Изображение
Иногда у нас уже есть двоичное дерево, и нам нужно определить, является ли оно BST (Binary Search Tree, двоичное дерево поиска). Эта проблема имеет простое рекурсивное решение. Свойство BST - каждый узел в правом поддереве должен быть больше текущего узла, а каждый узел в левом поддереве должен быть меньше текущего узла - является ключом к выяснению, является ли дерево BST или нет. Жадный (greedy) алгоритм - просто обход дерева, на каждом узле проверка, содержит ли узел значение, большее, чем значение у левого дочернего элемента и меньше, чем значение у правого дочернего элемента, - не работает во всех случаях. Рассмотрим следующее дерево: 20 / \ 10 30 / \ 5 40 В приведенном выше дереве каждый узел удовлетворяет условию, что узел содержит значение, большее, чем его левый дочерний элемент, и меньше, чем его правый дочерний элемент, и все же это не BST: значение 5 находится в правом поддереве узла, содержащего 20 , нарушение свойства BST. Вместо тог...